AIが働き始めるまでの「空白」を縮める
監視カメラが動くものを見つけ、ロボットが人を避け、車載機器が周囲の変化を判断する。身近な機械にもAIが入り込む時代、その性能を決めるのは演算装置の速さだけではない。電源を入れてから認識を始めるまでの時間、そして一度の判断に使う電気の量が、機器の使い勝手と電池寿命を左右する。
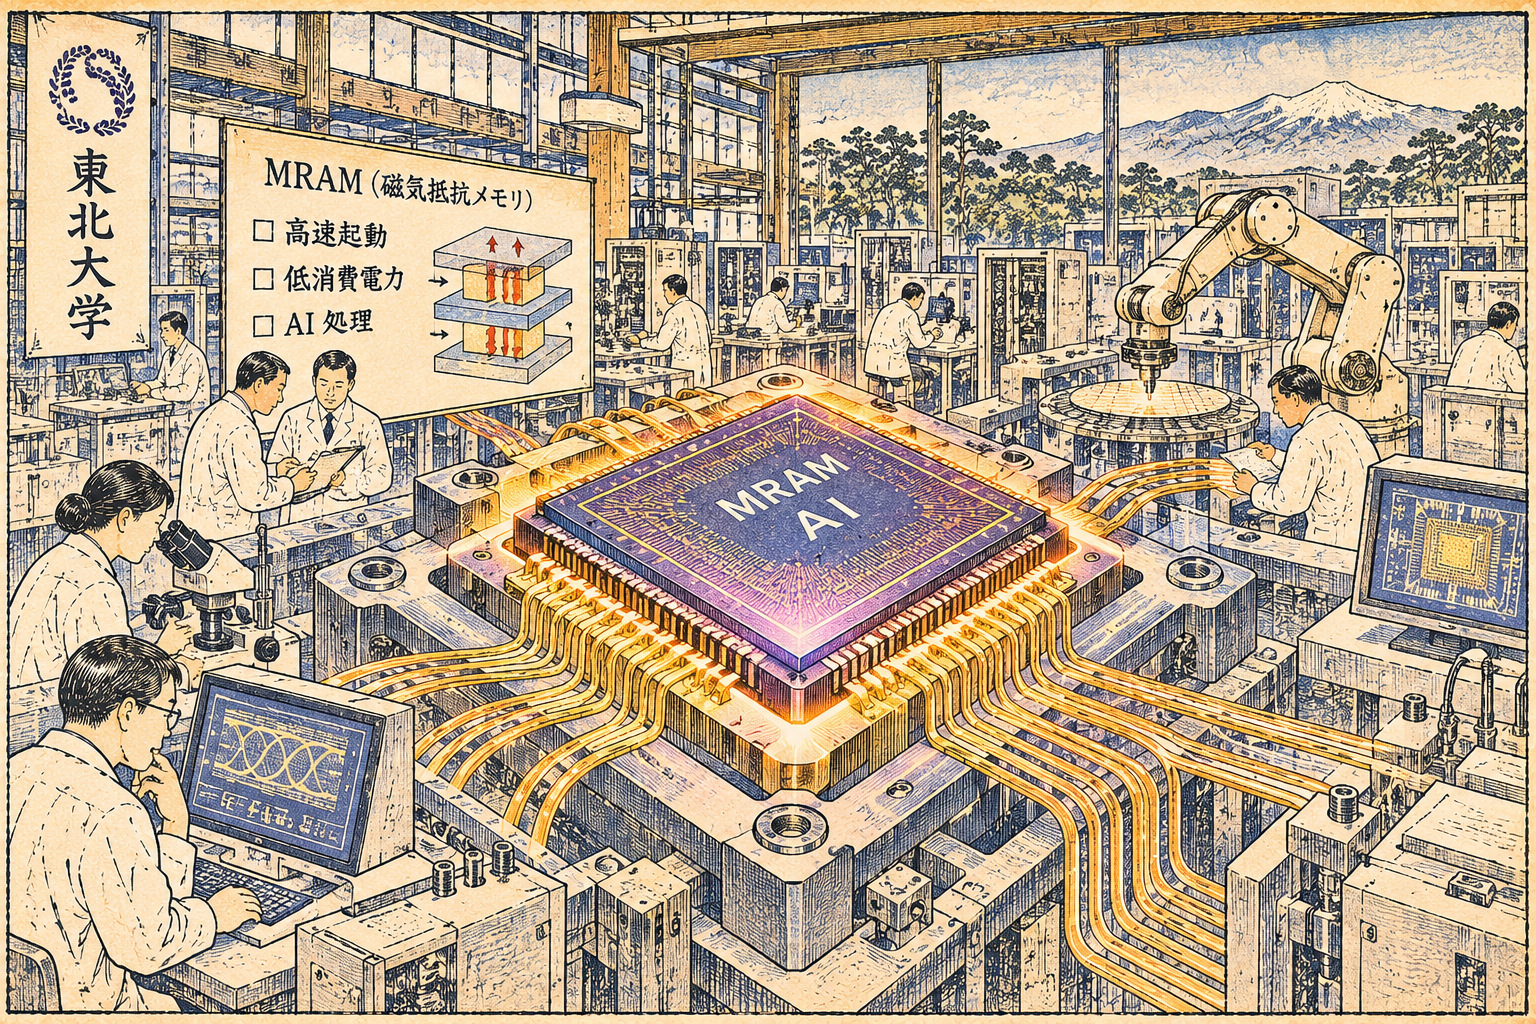
東北大学と株式会社アイシンが11月2日に発表した半導体は、そうした「起動の手間」を根本から減らそうとするものだ。16ナノメートルFinFET技術で作ったAI向けSoC(システム・オン・チップ)に32MBのSTT-MRAMを組み込み、OSの起動情報と画像認識AIの学習済み重みをチップ内に置いた。発表によると、電源投入からOSが立ち上がるまでの時間は65.7ミリ秒。
注目すべきは数字の小ささだけではない。起動や認識のたびに外部記憶装置から情報を移す必要を減らし、AIを「必要なときだけ動かす」設計を現実に近づけた。半導体の高速化というより、半導体の中で何を保存し、何を動かさないかという設計思想の転換である。
65.7ミリ秒が意味する範囲を正確に読む
大学の公表値を混同してはならない。65.7ミリ秒は「電源投入からOS起動まで」であり、カメラが撮影し物体を認識する一連の処理がすべて65.7ミリ秒で終わるという意味ではない。OS起動の比較では、従来方式に対し38.59倍の高速化を確認したとしている。
AI演算については、モデル重みの外部メモリーからの転送を減らした結果、処理時間が比較方式の約10.16分の1になった。起動と演算などを組み合わせたシステム全体の所要時間では25.2倍の短縮を報告する。それぞれ異なる工程を測っているため、数字を一つの「AI速度」にまとめることは適切ではない。
エネルギー面では、物体検出1フレームあたり50.7ミリジュール(mJ)で、比較システムの約50分の1とする。ただし、これは特定のTiny YOLOv3モデルと評価条件で得られた値であり、あらゆる画像認識機器の電池寿命が50倍になるという結果ではない。
鍵は32MBの磁気メモリーにある
一般的なコンピューターでは、CPUやAIアクセラレーターが演算する一方、プログラムやデータは別の場所に格納される。電源を入れれば記憶装置からOSやモデルを読み出し、DRAMへ移し、処理装置が必要な情報を繰り返し取りに行く。複雑な処理では計算よりもデータの移動が時間と電力を消費することがある。
STT-MRAM(スピン注入磁化反転型磁気抵抗メモリー)は磁性材料の状態で情報を記録する不揮発性メモリーだ。電源を切っても内容を保てるため、起動のたびに外部のSSDなどからすべてを読み直す必要を減らせる。今回の試作チップでは、その特徴をOS起動情報とニューラルネットワークの重みの双方に利用した。
ただし、32MBがあればどのAIモデルでも動くわけではない。用途に応じてモデルを小型化し、何をメモリー内に置くかを厳密に設計する必要がある。今回の成果は、記憶容量と演算方式を一緒に考えたところにある。
演算器のそばにデータを置く「近メモリー計算」
研究チームは設計を「近メモリーコンピューティング(Near-Memory Computing、NMC)」と説明する。記憶と計算を同じ空間へ近づけ、処理装置に情報を運ぶ距離と回数を少なくする考え方だ。電力効率をめぐる競争では、一秒あたりの演算回数だけを増やしても解決しない壁がある。
半導体の外側にあるメモリーとの通信は、回路内部の短い配線と比べて負担が大きい。しかも、AIの物体検出では学習済みの重みを何度も参照する。チップ内のSTT-MRAMから直接重みを読み出せれば、起動や推論に関わる転送待ちを抑えられる。
近メモリー計算は、メモリー素子そのものの中で算術演算する「インメモリー計算」と必ずしも同じではない。今回の実装はAI演算器の近くに不揮発性メモリーを配置し、モデルの供給を効率化する方式として理解するのが正確だ。
小さなモデルを載せるための8ビットと16ビット
実証に用いたのは、画像に含まれる物体の種類と位置を推定するTiny YOLOv3である。大規模言語モデルを実装したわけでも、生成AIの文章出力速度を測ったわけでもない。狙いは現場のカメラやロボットに適した画像認識を、少ない電力で動かすことにある。
研究チームは8ビットと16ビットを使い分けるハイブリッド乗算アーキテクチャーを取り入れた。さらに重み共有によって必要な記憶容量を抑え、32MBというオンチップの制約下でもモデルを動かした。限られた資源を「最大限に詰め込む」ことと、精度や速度のバランスを取ることは同じ問題の表と裏だ。
モデルの精度がどの場面で十分かは、撮影条件、対象物、照明、誤認識の許容度によって変わる。大学の発表は高速起動とエネルギー性能の実証を示すが、製品ごとの安全性・認識精度の認証を示したものではない。
磁気と半導体の融合は、突然始まったわけではない
東北大学はスピントロニクスとCMOS回路の融合に長年取り組んできた。国際集積エレクトロニクス研究開発センター(CIES)の研究には、磁気トンネル接合を使ったメモリー素子、300mmウエハーでの製造、回路設計、画像認識向けプロセッサーなどを産学で結ぶ構想がある。
2024年10月11日には、東北大とアイシンが大容量MRAMを用いるCMOS/スピントロニクス融合AI半導体について、従来比10倍以上の電力効率をシステム動作シミュレーションで確認したと発表した。これは実チップの全項目を測定したという報告ではなかった。
2026年の発表は16nm試作チップでOS起動時間や物体検出の消費エネルギーを示した点で、研究を新たな段階に進めた。ただし、2024年のシミュレーションと2026年の測定は比較対象も評価方法も異なり、「10倍が50倍へ改善した」と単純に連続した同一指標として扱うべきではない。
研究者と企業が担った役割
共同研究の中心は、東北大学国際集積エレクトロニクス研究開発センター長で大学院工学研究科教授の遠藤哲郎氏らと、株式会社アイシンの開発陣である。大学が公表した発表論文の著者は遠藤哲郎、成瀬峰信、李奕、池田正二、安平光雄、山田洋の6人。所属と漢字表記は大学の日本語発表に従った。
成果の発表先は台湾・新竹市で11月1~4日に開催されたIEEE Asian Solid-State Circuits Conference(A-SSCC)2026。論文題名は「A 65.7ms Quick-instant-on and 50.7mJ/frame Tiny YOLOv3-based Object-detection 16nm-AI-SoC with 32MB-embedded-MRAM and Hybrid-multiplication-architecture」である。
研究の一部には新エネルギー・産業技術総合開発機構(NEDO)の委託事業が関わった。大学・自動車部品メーカー・公的研究開発資金の組み合わせは、次世代半導体を研究室の実験から応用へ結び付ける日本の産学連携の一例でもある。
車、工場、カメラ――どこに用途があるのか
自動車では周囲の状況を見張る認識装置、工場では異常を検知するセンサー、家庭では必要なときだけ動くカメラなど、省電力と即応性を両立したい場所が多い。とりわけ、常に動かし続けるのではなく、必要なときだけ起動する設計には不揮発性メモリーの利点が大きい。
もっとも、開発を担ったアイシンが特定車種への採用を決定した、量産日程を定めた、あるいは自動運転車の安全性能を実証したという発表は確認できない。研究発表に記された「応用可能性」と、すでに市場で使われている技術を区別する必要がある。
実際の製品ではカメラからの画像入力、センサーとの同期、車載温度での信頼性、サイバーセキュリティー、保守・更新の仕組みなども重要になる。チップ単体のベンチマークを、完成システムの安全性や経済性へ読み替えることはできない。
50倍という数字が示さないこと
物体検出1フレームあたり50.7mJという測定値は興味深いが、それはどのような比較構成と処理条件を採用するかに左右される。外部メモリーを持つ比較システムでは転送に時間と電力がかかる一方、近メモリー設計ではその負担を抑えられる。
ただし、エネルギーが50分の1という数字は、全機器の電池寿命やクラウドAIの消費電力が一律に50分の1になることを意味しない。ディスプレー、無線通信、センサー、待機回路などの消費電力は別に存在する。また、発表資料だけでは任意の競合製品との同一条件比較を保証することはできない。
半導体を商用化するには歩留まり、製造コスト、量産可能な組込みMRAMの容量、データ書き換え耐久性、熱環境、性能ばらつきなどを調べる必要がある。研究の価値はこうした論点を消したことではなく、実チップによる評価の出発点を作ったところにある。
「世界初」をどう受け止めるべきか
大学とアイシンは発表の見出しで「世界初」とうたう。ただし、その対象はSTT-MRAMを組み込んだ16nm AI SoCという特定構成の成果として読むべきだ。世界に先例となる不揮発性メモリー、AIアクセラレーター、低消費電力チップが一切存在しなかったという意味ではない。
技術的な強みは、非揮発記憶、モデルの小型化、ハイブリッド乗算、近メモリーの配置、短時間起動を一つのシステムとして組み合わせ、評価した点にある。成果は11月の国際学会で報告されているが、査読付き学術雑誌での追試や独立評価が完了したと断定する資料ではない。
今回の発表を評価する際には、発表済みの数字、測定条件、商用製品との差を区別することが何より重要だ。小さな数字を過度に煽らなくても、情報の移動を減らすという工夫は十分に面白い。
AI半導体の競争は「何を動かさないか」へ
生成AIの大規模計算では巨大なGPUと高速メモリーが注目される。一方、エッジ機器では電池容量、設置場所、発熱、起動時間が設計の自由度を制限する。数千億の演算を可能にする力より、一度の必要な判断を小さな電力で済ませる知恵が重要なこともある。
東北大とアイシンの研究は、電源を切っても残る情報をAI演算器の近くに置くことで、起動と認識の両方を効率化できることを示した。未来の実用製品がどの程度の性能、価格、信頼性を達成できるかは未確定だ。それでも、何を速く計算するかと同じくらい、何を遠くへ運ばないかが性能を決める。
65.7ミリ秒とは、単なる記録更新の数字ではない。AIを常時働かせる以外の選択肢を増やすための、回路と記憶の再設計を示す数字なのである。
出典・取材方法
東北大学および株式会社アイシンの日本語共同発表、2024年の関連公表、東北大学CIESの研究紹介を照合した文書取材。原著会議論文の全文査読や研究者への独自取材は実施していない。