荷物を置く、その一瞬前に
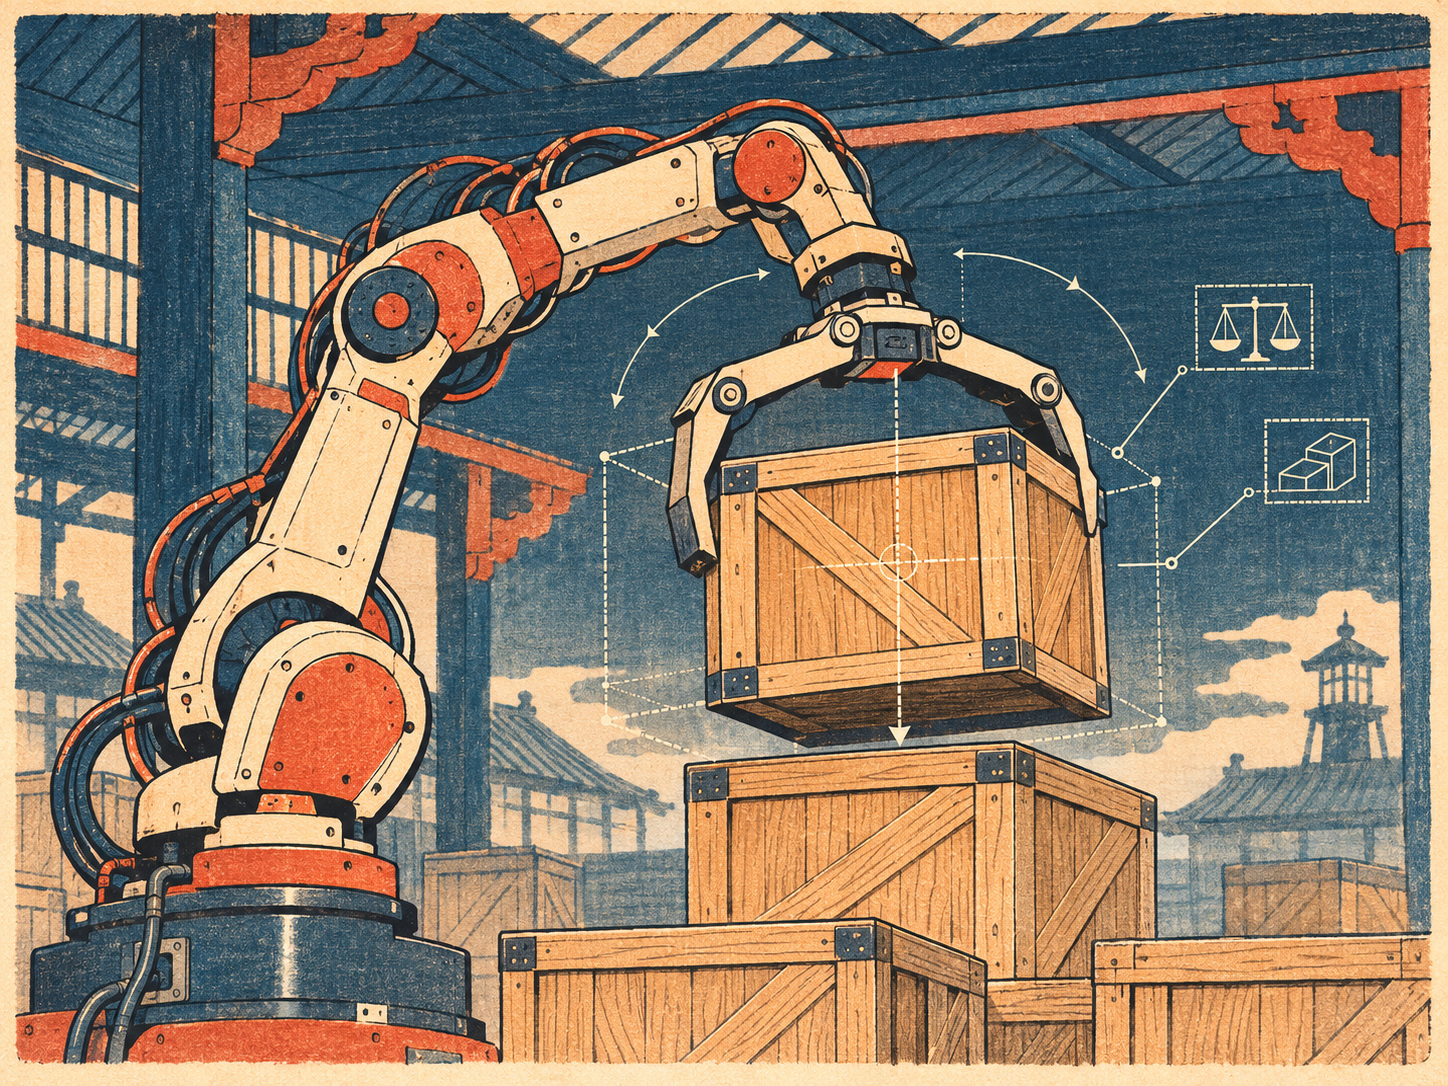
空港の手荷物を思い浮かべてほしい。四角いスーツケース、柔らかい旅行かばん、取っ手が突き出した箱。人なら重さや傾き、下にある荷物との接し方を見て、置き直すことがある。ロボットが同じことをするには、目的の場所まで腕を動かすだけでは足りない。置いた直後に何が起きるかを考える必要がある。
NTT株式会社は2026年11月11日、ロボットが動作に移る前に複数の行動案の結果を予測し、荷崩れや落下を避けやすい方法を選ぶための「ワールドモデル」を発表した。物体の重さ、位置、向き、速度などを明示的に扱い、運動方程式による計算を映像生成と結び付ける。華やかな言葉に置き換えれば「動く前に未来を見る」技術だが、その核心は、実世界で失敗する可能性を判断に織り込む点にある。
73.1%から92.3%へ――何を測ったのか
NTTの発表によると、小型ロボットで棚に物品を積む模擬タスクを行い、技術の適用前後で成功率を比較したところ、73.1%から92.3%に上昇した。差は19.2ポイント。相対的な改善率に換算すれば約26%だが、成功率そのものが26ポイント増えたという意味ではない。
試験は研究室の棚積み作業を模したものであり、実際の空港で多種多様な手荷物を運ぶ実験結果ではない。発表資料にはこの数字を一般化するために必要な試行回数、運用期間、全条件での統計的不確かさが十分には示されていない。したがって「どんな荷物でも92.3%成功する」とは書けない。数字が示すのは、比較した特定の作業で行動前の予測が有効だったということだ。
映像を生成するAIが、なぜ物理を必要とするのか
映像生成AIは見た目に自然な動きを作れる一方、重い箱が突然消えたり、衝突すべき物体がすり抜けたりすることがある。現実の倉庫では、こうした映像上の不整合は単なる画質の問題ではない。落下や挟み込みにつながる判断ミスになり得る。
NTTが「物理制御アダプタ」と呼ぶ仕組みは、映像から推定した物体の位置、姿勢、速度、質量などを使って物理法則に沿う次の状態を計算し、その情報を映像生成モデルに反映する。生成された未来の映像を比較し、落下や衝突が起きにくい行動を選ぶ。生成AIと古典力学を対立させるのではなく、互いの不得意な部分を補わせようという設計思想である。
命令するAIと、結果を吟味するAI
ロボットの行動案は、画像と言語から動作を導くVLA(Vision-Language-Action)モデルや、動作の経路を計算するモーションプランナなどが作る。今回の技術は、それらをすべて置き換えるものではない。候補を実行した場合の結果を別の仕組みで調べ、採用する案を絞る役割を担う。
例えば、同じ箱を右寄りに置くか、左にずらすか。到達できる位置が複数あっても、荷物の支え方は違う。動作可能性だけでなく、置いた後の安定性を評価することが重要になる。発表された構成は既存の制御ソフトとの連携を前提としており、工場のロボットを一度に丸ごと置き換える話ではない。
「未知の荷物」への対応力はどこまであるか
データだけに頼る方式では、学習時にほとんど見なかった形状や接触条件に遭遇すると予測が外れやすい。NTTは、物理量を内部で扱うことで学習データに含まれない状況にも対応しやすくなると説明する。ロボットアームによって物体の一部が隠れるような場面も評価対象として挙げている。
さらに、複数の物体が衝突する映像を含む公開データセット「OBJ3D」で予測映像を比較し、知覚的な画像の違いを測るLPIPS指標では従来手法を上回ったという。ただし映像の見た目の一致度だけで、現場の安全性や荷物の損傷率は測れない。接触力、摩擦、材質、センサーの誤差まで実運用で検証する必要がある。
日本の産業用ロボットは何を得意としてきたのか
日本の産業用ロボットの歩みを振り返ると、1968年に川崎重工が米国ユニメーション社と技術提携し、1969年に国産初の産業用ロボット「川崎ユニメート2000型」の商業生産を始めた。溶接や搬送のように工程と位置が決まった仕事で、繰り返し精度と稼働率を磨いてきた歴史である。
その強みは今も大きい。自動車工場など、対象物と治具を厳密に管理できる場所では、工程を専用化することが高い生産性につながる。一方、空港の手荷物や宅配便では、箱の形も中身も毎回違う。今回のNTT技術は、日本が得意としてきた精密な動作制御に、変化の多い環境で結果を見積もる能力を加えようとする試みと読める。
半世紀前の「考えるロボット」との接点
周囲を観察し、行動を計画するロボット研究は突然始まったわけではない。米国SRIの「Shakey」は1966~1972年に研究され、カメラなどで環境を把握し、部屋を移動して簡単な物体を扱うための計画を立てた。AIと実際の機械動作を結ぶ先駆けだった。
当時の課題は、限られた計算能力と単純化された環境の中で、どの行動を取るべきかを決めることだった。今日の違いは、高度な視覚処理や生成モデルが使える点にある。しかし、行動の結果を事前に考えるという問いそのものは変わらない。新しいのは、その問いに映像生成と明示的な物理計算を組み合わせたことだ。
空港で使うには何が足りないのか
NTTが最初に想定するのは、形も重さも異なる航空手荷物の積込み・積降ろしだ。同社は株式会社Mujinと連携し、現場に近い実証を進める方針を示している。物流倉庫や製造、建設、小売への展開も構想として挙げる。
しかし、空港の現場で求められるのは単発の成功率だけではない。1時間当たり何点処理できるか、予測計算は作業速度を遅くしないか、ベルトコンベヤーが止まった時にどう復旧するか。重心の異なるかばん、破れやすい外装、雨で濡れた荷物、センサーの死角、人との近接作業なども検証対象となる。経済性と安全性を同時に満たすことが実装の条件だ。
11月の展示と、まだ見えていない数字
NTTは11月18~20日と24~25日に開催される「NTT R&D FORUM 2026」で成果を展示する予定だ。発表時点では展示予定であり、開催後の実績ではない。技術の実用度を判断するには、作業条件を変えた独立試験や、失敗時の被害、モデルの計算遅延を含めた結果が必要だ。
NTTは映像生成モデルに物理制御アダプタを統合したことを「世界初」と説明するが、技術的な優先権の主張は企業によるもので、今回参照できた資料だけで世界中の先行研究を網羅的に検証したわけではない。技術の価値は、優先権の看板よりも、異なる現場で予測と行動の品質を再現できるかにある。
失敗しない機械ではなく、失敗を減らせる機械へ
未来を読むという表現には、つい万能性を期待したくなる。しかしロボットが見積もるのは、得られたセンサー情報とモデルの仮定に基づく、いくつかの未来の可能性だ。想定外の形状、見えない内部の重さ、摩擦や人の介入などによって、その予測は外れ得る。
それでも、動かしてから失敗に気付く仕組みより、動かす前に複数案を点検できる仕組みには明確な意味がある。1969年の国産産業ロボットが決まった動作を繰り返す時代を切り開いたとすれば、次の課題は変わり続ける環境に合わせて行動を選び直すことだ。NTTが示した成果は、その難題への一つの具体的な回答である。
出典・確認事項
調査方法:NTT公式発表を主資料として検証し、産業用ロボット史は川崎重工業、Shakeyの研究史はSRIの資料に拠った。取材先への独自インタビュー、空港での現場試験、査読付き論文の独立再現は行っていない。